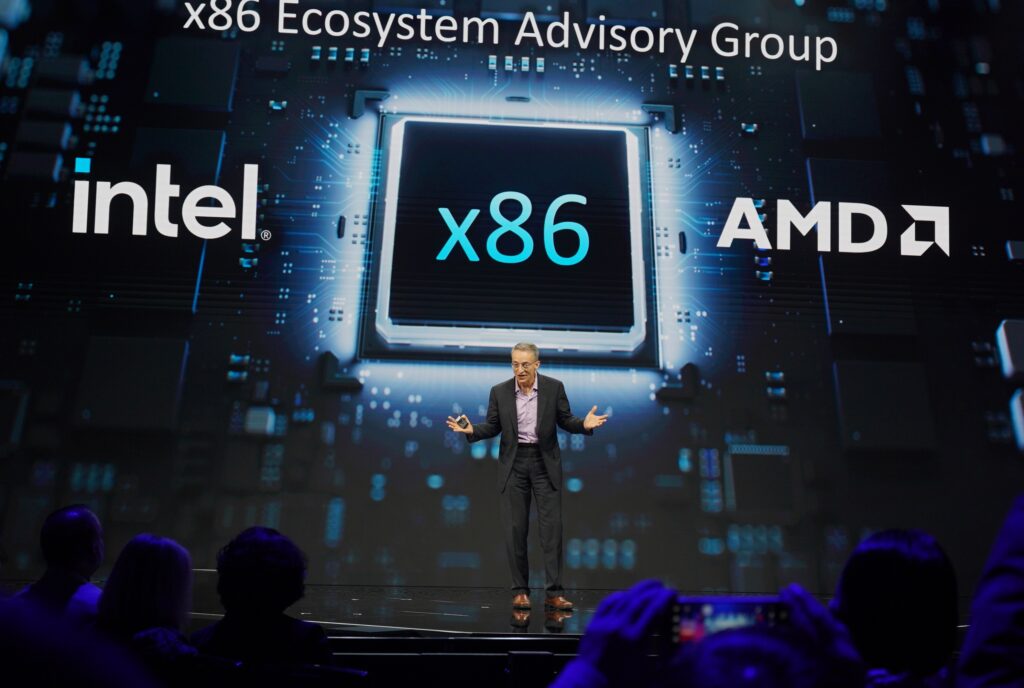
Dentmas.id – Dunia teknologi sedang diramaikan oleh langkah historis dari dua raksasa prosesor yang selama ini kerap bersaing sengit. Intel dan AMD secara resmi telah meluncurkan spesifikasi lengkap untuk sebuah standar anyar bernama Advanced Computing Extensions, atau yang lebih akrab disapa ACE. Standar revolusioner ini dirancang khusus untuk arsitektur prosesor x86 dengan satu tujuan utama: membuat beban kerja kecerdasan buatan (AI) berjalan jauh lebih efisien dari sebelumnya.
Selama bertahun-tahun, persepsi umum di kalangan teknisi dan penggiat AI selalu mengarah pada chip grafis atau GPU sebagai kuda pacu utama untuk pemrosesan AI. Memang tidak bisa dipungkiri, GPU memiliki ribuan inti yang mampu memproses data paralel dalam jumlah besar, sehingga sangat cocok untuk melatih model-model AI raksasa. Namun, perlu kita sadari bersama bahwa tidak semua tugas AI diciptakan sama, dan tidak semuanya merasa nyaman tinggal di “rumah” GPU.
Untuk model AI yang berukuran lebih kecil atau aplikasi yang menuntut respons super cepat untuk pengguna tunggal—seperti asisten virtual real-time atau fitur prediksi di perangkat pribadi—mengandalkan CPU ternyata merupakan pilihan yang jauh lebih cerdas. Mengapa demikian? Karena CPU menghilangkan kebutuhan rumit untuk memindahkan data bolak-balik antara CPU dan GPU, sebuah proses yang sering kali memakan waktu dan daya. Proses perpindahan data ini, jika terlalu sering terjadi, justru dapat menciptakan hambatan (bottleneck) yang memperlambat kinerja keseluruhan sistem.
Lebih lanjut, kita juga tidak bisa menutup mata terhadap fakta bahwa masih sangat banyak perangkat di luar sana yang tidak dilengkapi dengan GPU khusus yang mumpuni. Banyak laptop tipis, PC kantoran, dan perangkat edge computing hanya mengandalkan GPU terintegrasi dengan kemampuan yang sangat terbatas untuk urusan komputasi berat. Di sinilah celah besar tersebut berhasil diidentifikasi oleh Intel dan AMD, dan mereka pun bergerak cepat untuk mengisinya dengan menghadirkan ACE sebagai solusi jitu.
Nah, apa sebenarnya yang membuat ACE begitu istimewa dan dinanti-nantikan? Standar teknis yang baru ini tidak serta-merta menciptakan sesuatu dari nol, melainkan memanfaatkan secara cerdas fondasi yang sudah ada, yaitu instruksi AVX10 yang telah tertanam di prosesor x86. Namun, yang membedakan adalah penambahan komponen silikon khusus yang didesain secara spesifik untuk menangani operasi perkalian matriks (matrix multiplication). Bagi orang awam, perkalian matriks mungkin terdengar seperti pelajaran matematika membosankan, tetapi bagi dunia AI, proses komputasi ini adalah fondasi utama yang menjadi jantung dari hampir seluruh model AI modern yang kita kenal saat ini.
Fokus Utama: Mengupas Tuntas Efisiensi AI ala ACE
Mari kita bedah lebih dalam mengenai spesifikasi yang telah dirilis oleh Intel dan AMD. Diklaim dengan jelas bahwa ACE memungkinkan CPU untuk menjalankan operasi matriks dengan tingkat efisiensi yang jauh lebih tinggi dibandingkan pendekatan kuno yang hanya mengandalkan instruksi AVX10 standar. Perkalian matriks memang merupakan proses inti yang terus-menerus terjadi dalam berbagai model AI, mulai dari chatbot canggih yang bisa diajak ngobrol, sistem rekomendasi di platform streaming yang tahu persis film favorit kita, hingga aplikasi visi komputer yang mampu mengenali wajah dan objek.
Sebelum kemunculan ACE, operasi perkalian matriks sebenarnya tetap bisa dijalankan di CPU menggunakan instruksi AVX10. Namun, para insinyur Intel dan AMD menilai metode tersebut masih sangat kurang optimal. Mengapa? Karena AVX pada awalnya dirancang untuk pemrosesan vektor satu dimensi, bukan untuk matriks dua dimensi yang menjadi format data utama dalam algoritma AI kontemporer. Hal ini menyebabkan terjadi banyak pemborosan siklus clock dan energi.
Dengan mengadopsi ACE, jumlah operasi yang dapat diproses untuk jumlah vektor input yang sama diklaim mampu melonjak hingga 16 kali lipat dibandingkan metode AVX10 sebelumnya. Bayangkan, peningkatan kapasitas komputasi yang begitu besar dalam satu paket standar yang sama! Namun, kita perlu bijak dalam menafsirkan angka ini. Peningkatan jumlah operasi tersebut tidak secara otomatis serta-merta berarti performa akhir akan melesat 16 kali lebih cepat di semua skenario. Kecepatan aktual yang dicapai pada akhirnya akan sangat bergantung pada implementasi teknis dari masing-masing produsen chip ketika mereka mulai memproduksi prosesor dengan dukungan ACE nantinya.
Meskipun demikian, yang perlu kita soroti dengan gembira adalah ACE terbukti mampu mengurangi jumlah instruksi yang harus dieksekusi oleh CPU secara signifikan. Implikasinya sangat besar: konsumsi daya listrik menjadi lebih rendah (irit baterai untuk perangkat mobile!), penggunaan bandwidth memori menjadi lebih efisien (tidak boros mengakses RAM), dan yang paling penting, panas yang dihasilkan pun dapat ditekan. Ini adalah kabar baik bagi para pengguna laptop yang selama ini mengeluhkan perangkatnya cepat panas saat menjalankan aplikasi AI ringan.
Memudahkan Nyawa Para Pengembang AI di Seluruh Dunia
Selain fokus pada peningkatan efisiensi perangkat keras, kehadiran ACE juga membawa angin segar bagi ekosistem pengembangan perangkat lunak. Standar ini dirancang dengan semangat lintas implementasi (cross-implementation), sebuah filosofi yang sangat memudahkan pekerjaan para developer. Artinya, para pengembang framework AI populer seperti PyTorch dan TensorFlow nantinya hanya perlu membuat satu jalur kode (single code path) yang dapat berjalan mulus di berbagai prosesor x86 yang mendukung ACE.
Dengan kata lain, mereka tidak perlu lagi pusing-pusing menyesuaikan optimasi kode untuk setiap jenis prosesor tertentu atau repot-repot mendeteksi tingkat dukungan AVX yang berbeda-beda di tiap chip. Pendekatan yang seragam ini secara dramatis akan mempercepat siklus pengembangan aplikasi AI dan mengurangi potensi bug yang muncul akibat perbedaan implementasi perangkat keras. Semua orang diuntungkan: pengembang jadi lebih produktif, dan pengguna akhir mendapatkan pengalaman yang lebih stabil.
Tidak berhenti di situ, standar baru ini juga menunjukkan fleksibilitasnya dengan mendukung berbagai format data yang umum digunakan dalam dunia machine learning modern. ACE dengan lapang dada menerima format INT8, INT32, FP8, FP16, FP32, hingga BF16. Bahkan, mengutip laporan dari Toms Hardware, ACE disebut-sebut mendukung format MX block-scaled milik Open Compute Project secara native (asli), sebuah kemampuan keren yang sama sekali tidak tersedia pada instruksi AVX10 sebelumnya. Dukungan format yang luas ini memastikan bahwa ACE dapat diadopsi oleh berbagai macam aplikasi AI tanpa perlu konversi data yang memakan waktu.
Intel dan AMD optimis bahwa pendekatan terbaru ini akan mempermudah para pengembang dalam menjalankan model AI langsung di CPU. Pada akhirnya, hal ini secara efektif mengurangi ketergantungan industri pada perangkat keras khusus seperti NPU (Neural Processing Unit) untuk beberapa jenis beban kerja tertentu yang mengutamakan kecepatan respons (low-latency). Dengan dirilisnya spesifikasi ACE secara resmi ke publik, Intel dan AMD telah membuka jalan lebar bagi generasi prosesor x86 berikutnya yang akan jauh lebih siap dalam menghadapi ledakan kebutuhan komputasi AI yang terus meningkat setiap harinya.
Inovasi ini bukan sekadar peningkatan teknis biasa; ini adalah sinyal kuat bahwa persaingan di era AI tidak lagi hanya menjadi ajang monopoli bagi GPU. Pertempuran kini mulai merambah ke CPU, sang tulang punggung komputasi modern yang selama ini mungkin dianggap kurang gaul untuk urusan AI. Dengan ACE, masa depan komputasi AI yang lebih cepat, lebih dingin, dan lebih efisien kini semakin nyata di depan mata!
Temukan juga berbagai berita terbaru lainnya hanya di Exposenews.id.