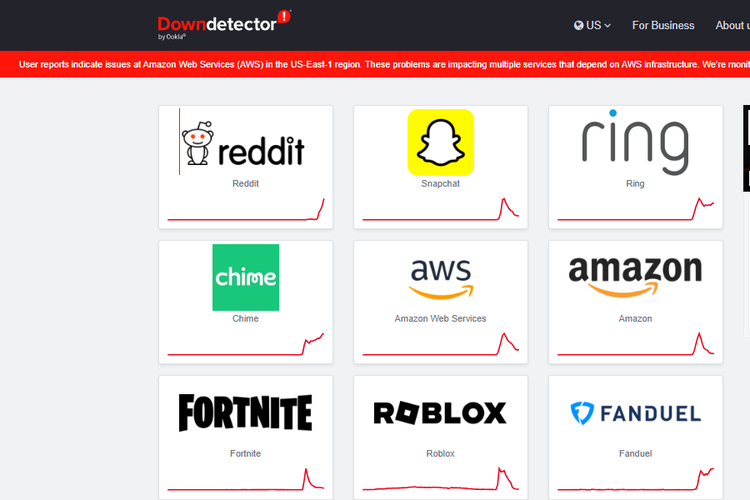
Dentmas.id – Dunia online sempat diguncang “kiamat kecil”! Akibatnya, raksasa cloud computing asal Amerika Serikat, Amazon Web Service (AWS), secara resmi menyampaikan permintaan maaf atas gangguan besar yang melanda layanan mereka pada Senin, 20 Oktober 2025. Selanjutnya, gangguan parah ini berhasil melumpuhkan lebih dari 1.000 situs dan aplikasi populer di seluruh dunia, mulai dari Canva, Roblox, Fortnite, hingga Reddit, Snapchat, dan Signal. Bahkan, pengguna di Indonesia pun turut merasakan dampak berantai ini. AWS dengan rendah hati menyatakan, “Kami mohon maaf atas dampak yang ditimbulkan oleh peristiwa ini kepada pelanggan kami.” Tak hanya itu, mereka juga menegaskan, “Kami tahu betapa pentingnya layanan kami bagi pelanggan, aplikasi dan pengguna akhir mereka, serta bisnis mereka,” sambil berjanji akan mengambil pelajaran berharga dari insiden ini dan memastikan kejadian serupa tidak terulang lagi.
Permintaan Maaf AWS dan Janji Perbaikan
Selain permintaan maaf tulus, AWS juga secara terbuka mengungkapkan penjelasan teknis yang mendetail mengenai akar masalah pada 20 Oktober lalu. Secara garis besar, tiga gangguan utama berhasil diidentifikasi di infrastruktur AWS, yaitu sebuah bug nakal di sistem DNS, kesalahan fatal di jaringan, dan proses sinkronisasi yang tiba-tiba menjadi sangat lambat. Pada akhirnya, kombinasi masalah ini memicu efek domino yang dahsyat, sehingga membuat situs dan layanan yang menggantungkan diri pada infrastrukur AWS ikut down beramai-ramai.
Kaskade Gagal yang Dimulai dari Pusat Data Vital
Lalu, dari mana semua ini berawal? AWS membeberkan bahwa gangguan global ini ternyata berakar dari sebuah kesalahan teknis di layanan basis data andalan mereka, Amazon DynamoDB, yang berlokasi di wilayah US-East-1 (Virginia, AS). Perlu kamu tahu, pusat data ini bukanlah pusat data sembarangan. Berdasarkan laporan Data Center Knowledge, US-East-1 yang dijuluki sebagai Data Center Alley (Gang Pusat Data) ini menjadi tulang punggung operasional 90 persen perusahaan Fortune 100. Dengan kata lain, pusat data ini menopang perusahaan-perusahaan terbesar dan terkuat di AS.
Kronologinya, gangguan mulai terjadi sejak 19 Oktober pukul 11.48 malam waktu setempat dan berlangsung hingga 20 Oktober pukul 02.40 pagi. Dalam kurun waktu tersebut, DynamoDB mengalami peningkatan tajam pada tingkat error API (application programming interface), yang akhirnya memutus koneksi banyak aplikasi ke server AWS. Alhasil, aplikasi dan situs yang bergantung pada sistem AWS pun tidak dapat memproses data pengguna, sehingga terlihat “mati” dari sisi kita semua.
Kegagalan Sistem DNS: Buku Telepon Internet yang Rusak
Apa pemicu sebenarnya? AWS mengungkapkan bahwa penyebab utamanya adalah “latent defect” atau cacat tersembunyi dalam sistem otomatis manajemen DNS (Domain Name System) milik DynamoDB. Sebagai gambaran, DNS bertugas layaknya “buku telepon internet” yang menerjemahkan nama situs (seperti canva.com) menjadi alamat IP numerik agar komputer dapat mengaksesnya. Namun, dalam insiden ini, sistem otomatis tersebut mengalami “race condition”, sebuah situasi kritis di mana terlalu banyak permintaan data masuk secara bersamaan ke titik akhir yang sama. Akibatnya, sistem pun menjadi bingung dan justru menghasilkan data kosong untuk alamat regional DynamoDB.
Lebih parah lagi, catatan DNS yang kosong ini secara otomatis membuat komputer atau aplikasi tidak dapat menemukan alamat server yang dituju. Situasi ini semakin runyam karena sistem otomatis AWS yang seharusnya memperbaiki kesalahan ini justru gagal berfungsi. Maka, bisa ditebak, catatan kosong itu bertahan selama berjam-jam dan menyebabkan aplikasi yang membutuhkan DynamoDB sama sekali tidak dapat terhubung.
Masalah Berantai: Jaringan dan Server Ikut Kolaps
Seolah satu masalah belum cukup, masalah baru justru muncul ketika AWS mulai memulihkan sistemnya. Kali ini, bagian jaringan yang disebut Network Load Balancer (NLB) ikut mengalami error. Bayangkan saja, NLB ini berperan sebagai polisi lalu lintas di jalan tol data. Tugasnya adalah mengatur arus data agar tidak menumpuk di satu server saja, sehingga semua pengguna dapat mengakses aplikasi dengan lancar. Sayangnya, antara pukul 05.30 pagi hingga 14.09 siang, alat pemantau kesehatan jaringan gagal mendeteksi masalah pada beberapa NLB. Dampaknya, beberapa NLB yang sebenarnya bermasalah justru dianggap “sehat”. Pada akhirnya, ketika lalu lintas data dialihkan ke server NLB yang “sakit” ini, koneksi pengguna pun gagal total.
Rantai masalah belum berakhir di situ. Gangguan di jaringan tadi kemudian diperparah oleh masalah lain di EC2, platform “mesin server virtual” AWS yang menjadi tulang punggung ribuan aplikasi besar seperti Canva dan Snapchat. AWS menjelaskan bahwa antara pukul 02.25 hingga 10.36 pagi, banyak server EC2 baru—yang seharusnya menggantikan server yang error—tidak bisa langsung terkoneksi. Meskipun pada pukul 10.37 pagi server sudah bisa diluncurkan kembali, beberapa server baru masih mengalami kendala koneksi hingga pukul 13.50 siang. Penyebabnya adalah keterlambatan sinkronisasi jaringan, yang membuat jaringan AWS sempat kebingungan membedakan server yang aktif dengan yang belum siap.
Langkah Konkret AWS Mencegah Terulangnya Kiamat Digital
Lantas, apa langkah perbaikan AWS? Dalam laporan pasca-insiden, AWS menyatakan komitmennya untuk melakukan perbaikan sistem dan audit internal secara besar-besaran. Perusahaan asal Seattle, Washington ini bertekad memastikan tiga penyebab utama—bug DNS, error jaringan, dan sinkronisasi lambat—tidak akan terulang di masa depan.
Langkah konkret pertama yang mereka ambil adalah dengan mematikan sementara sistem otomatis DNS di seluruh dunia. Ingat, sistem inilah yang sebelumnya salah mengatur “daftar alamat” server dan memicu kekacauan. Kemudian, untuk Network Load Balancer (NLB), AWS akan menambahkan mekanisme kontrol kecepatan. Mekanisme baru ini akan mencegah satu server NLB menurunkan kapasitasnya secara drastis dan tiba-tiba saat terjadi gangguan atau proses failover. Dengan demikian, jika nanti ada error di satu wilayah, sistem tidak akan langsung “menguras” kapasitas server dan memicu efek domino seperti sebelumnya.
Terakhir, AWS juga akan memperkuat sistem pengujian untuk layanan EC2, sang “mesin server virtual” andalan. Saat ini, mereka sedang menyusun paket tes tambahan untuk memastikan proses pemulihan otomatis dapat berjalan mulus dalam berbagai skenario, termasuk skala besar seperti ini. Tujuannya jelas: agar setiap kali AWS meluncurkan atau memulihkan server baru, sistem dapat mendeteksi dan memperbaiki masalah dengan lebih cepat, dan tidak lagi terlambat seperti yang kita saksikan bersama.
Dapatkan juga berita teknologi terbaru hanya di newtechclub.com